
Ascolta la versione audio!
Il lead scoring predittivo promette di dire alle vendite chi chiamare per primo, ma su un CRM non governato produce l'effetto opposto: priorità sbagliate, clienti attivi trattati come prospect e fiducia bruciata nel team commerciale. Il problema non è quasi mai il modello, è la qualità del dato che il modello legge. Noi di Webeing.net® Digital Agency lavoriamo ogni giorno su istanze HubSpot in cui l'AI va accesa dopo, non prima, di un lavoro di data governance. In questo articolo trovi i tre guasti ricorrenti, le cinque decisioni che costruiscono una single customer view e la checklist in sette punti da verificare prima di attivare qualsiasi automazione predittiva.
Capita di accendere un lead scoring predittivo su un CRM che sembrava in ordine e di ritrovarsi in cima ai contatti caldi un cliente che ha firmato il mese prima. Quando succede la colpa finisce quasi sempre sul modello, mentre il guasto sta un paio di livelli più in basso, cioè nei dati che il modello ha letto e ha considerato veri. Vale per HubSpot come per qualsiasi altra piattaforma, perché il problema non dipende dalla scelta del CRM ma da come ci sono entrati i dati.
Perché il lead scoring predittivo di HubSpot dà risultati sbagliati?
Nella maggior parte dei casi il problema non è il modello ma i dati su cui gira. Contatti duplicati, proprietà a testo libero, lifecycle stage fermi a una vecchia migrazione e segnali di acquisto conservati fuori dal CRM producono previsioni sbagliate, perché il modello legge quello che trova e lo considera vero.
I guasti ricorrenti sono quasi sempre gli stessi tre, e conviene cercarli in quest'ordine.
L'identità è frammentata. Lo stesso cliente vive come tre contatti, due aziende e un deal rimasto orfano dopo una migrazione, quindi il modello si trova davanti tre storie parziali invece di una intera e assegna punteggi a entità che nella realtà sono la stessa persona. È il guasto che produce gli errori più vistosi, perché un record orfano non porta con sé lo storico degli acquisti e viene letto come un contatto nuovo.
La semantica non è condivisa. Una proprietà "stato cliente" a testo libero con quattordici valori diversi, dove "attivo", "Attivo" e "in corso" sono ovviamente la stessa cosa per una persona e tre cose distinte per un algoritmo, rende inutilizzabile qualsiasi segmentazione. Lo stesso vale per le pipeline che fotografano il processo commerciale di due riorganizzazioni fa, perché nessuno ha mai avuto il tempo di aggiornarle.
I dati che pesano di più stanno altrove. Fatturato, consumi di prodotto, registrazioni delle call e ordini e-commerce vivono spesso fuori dal CRM, e sono proprio i segnali con il maggiore potere predittivo. Finché restano nel gestionale o nella piattaforma di billing, il modello lavora sulla parte meno informativa della relazione con il cliente.
Che cosa si intende per data governance applicata al CRM?
La data governance è l'insieme delle regole scritte che stabiliscono chi possiede un dato, che cosa significa, da quale sistema arriva e chi ha ragione quando due fonti si contraddicono. Applicata al CRM non è un progetto IT ma una serie di decisioni di processo, e senza quelle decisioni ogni automazione eredita l'ambiguità che c'era prima. È il presupposto che rende reali i vantaggi per cui il CRM è stato comprato.
La differenza rispetto alla semplice pulizia del database è che la bonifica è un'attività una tantum, mentre la governance è ciò che impedisce al disordine di riformarsi. Un'istanza ripulita senza regole torna nelle condizioni di partenza nel giro di un anno e mezzo, perché i duplicati si ricreano dai form, le proprietà a testo libero si riempiono di varianti e le pipeline si disallineano appena il processo commerciale cambia.
Che cos'è una single customer view e perché serve prima dell'AI?
Una single customer view è una sola versione verificata del cliente, ottenuta unendo i sistemi che ne contengono i dati e stabilendo per iscritto quale prevale in caso di conflitto. Non è una dashboard ma un insieme di decisioni sul modello dati, e la dashboard è semmai l'ultimo passo, oltre che il più facile.
Le decisioni che la rendono possibile sono cinque, e vanno prese prima di configurare qualsiasi cosa.
- Quale oggetto porta l'identità. Contact, company oppure un custom object quando il cliente reale è un'entità che HubSpot non modella di serie, come capita spesso nel B2B2C: sembra una scelta tecnica e invece condiziona tutto quello che viene dopo.
- Chi vince quando due sistemi si contraddicono. Se il gestionale dice attivo e il CRM dice churned serve una regola scritta, perché l'alternativa è una riunione ogni volta che il conflitto si presenta.
- Le regole di deduplica, cioè la chiave di matching, il criterio di sopravvivenza dei singoli campi e la frequenza con cui il controllo viene eseguito.
- La direzione delle sincronizzazioni. Impostare tutto bidirezionale è la scorciatoia che genera i loop di aggiornamento che si diagnosticano sei mesi più tardi, di solito con il cliente al telefono.
- Un dizionario dati in cui ogni proprietà ha un significato e un proprietario. È il punto che salta per primo perché sembra burocrazia, ed è l'unico che impedisce al CRM di tornare al punto di partenza.
Nessuna di queste decisioni si prende dentro il marketing, ed è esattamente lì che i progetti si incagliano.
Come si eliminano i contatti duplicati su HubSpot?
HubSpot mette a disposizione uno strumento nativo di gestione dei duplicati che propone le coppie sospette e permette di unirle. Perché funzioni servono però tre decisioni prese a monte, cioè la chiave di matching, il criterio di sopravvivenza dei campi e la cadenza del controllo, oltre a regole sui form che evitino di ricrearli.
Lo strumento nativo lavora bene sui casi evidenti, tipicamente stessa email o dominio aziendale coincidente, mentre fatica quando il duplicato nasce da indirizzi diversi della stessa persona o da ragioni sociali scritte in modo non uniforme. In quei casi conviene costruire una proprietà di matching calcolata, oppure intervenire via API con una logica di deduplica basata su più campi combinati.
La parte che viene dimenticata più spesso è la prevenzione. Se i form non sono progettati per riconoscere un contatto esistente e le importazioni avvengono senza una chiave univoca, i duplicati si riformano da soli e la bonifica va rifatta ogni sei mesi.
Come si impostano lifecycle stage e pipeline coerenti con il processo reale?
Lifecycle stage e deal stage devono corrispondere a passaggi che qualcuno compie davvero, non a come il processo era stato disegnato anni prima. Il presupposto è una definizione di MQL condivisa tra marketing e vendite, perché nessun modello di scoring riesce a riconciliare due definizioni diverse dello stesso momento.
In pratica significa fare tre cose.
- Verificare che ogni stage abbia un criterio di ingresso osservabile e non interpretabile, perché uno stage che dipende dal giudizio del singolo commerciale non produce dati confrontabili.
- Eliminare gli stage che nessuno usa più, dato che restano nei report e sporcano le conversioni del funnel.
- Far coincidere il passaggio di consegne tra marketing e vendite con un evento tracciato nel CRM, invece che con una conversazione su un canale di chat.
Quella conversazione sulla definizione di MQL va fatta tra persone, in una stanza, e richiede un allineamento tra i team che è la parte più critica dell'intero progetto, oltre che quella che dura di più. Ma senza quella non si va avanti.
Che cosa fa Breeze Intelligence e dove si ferma?
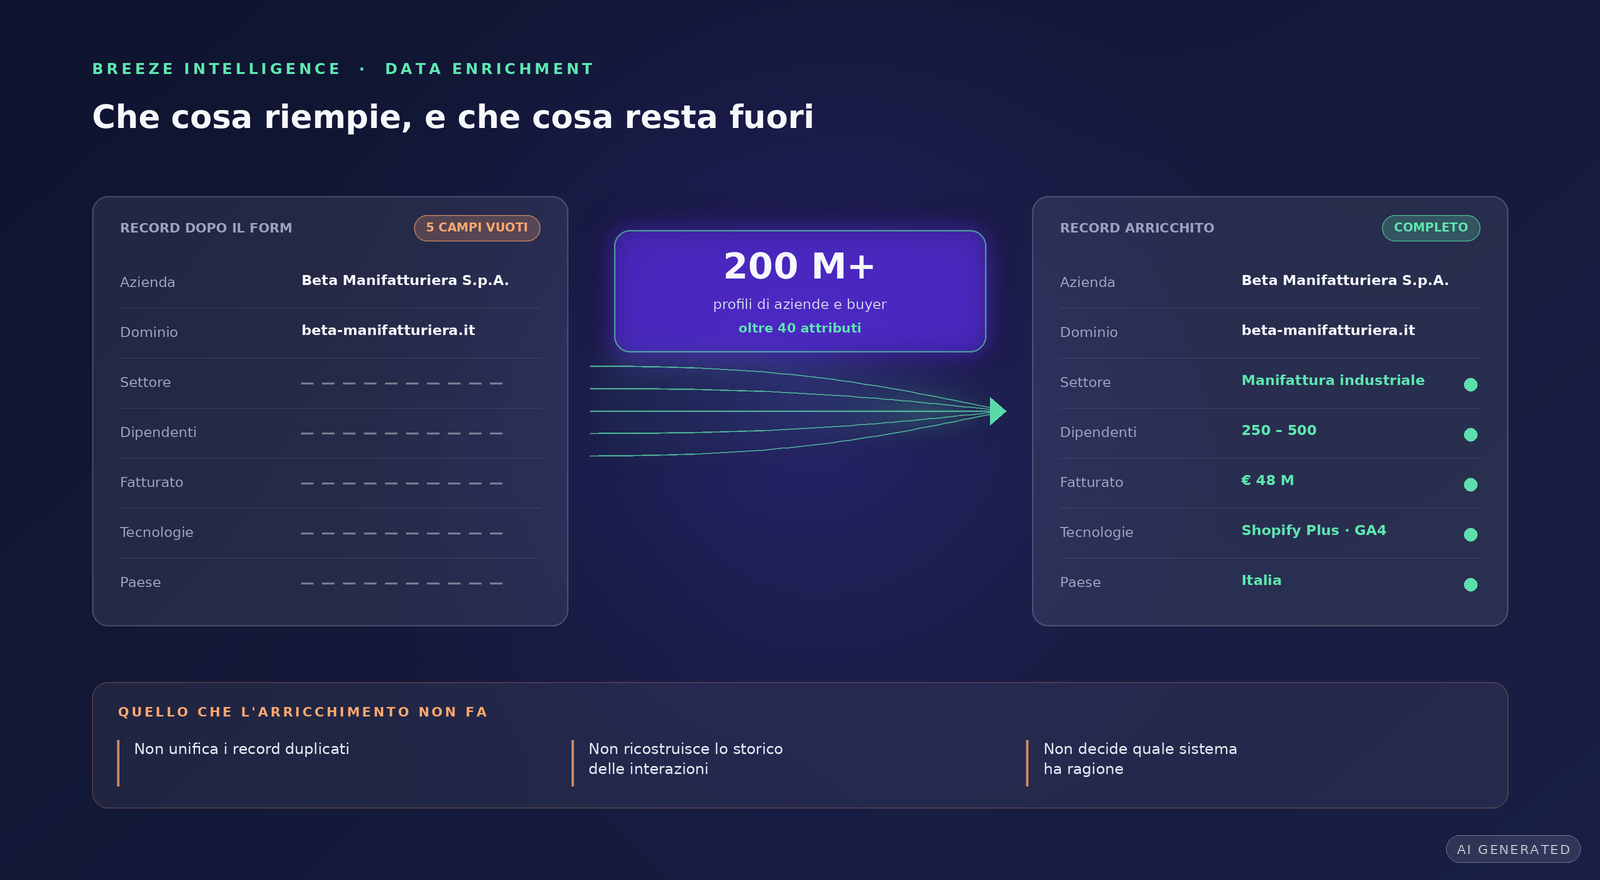
Breeze Intelligence completa gli attributi firmografici mancanti, ma non unifica i duplicati, non ricostruisce lo storico e non arbitra fra sistemi che si contraddicono. Dati di esempio.
Breeze Intelligence, il layer di intelligenza artificiale nativa di HubSpot, esegue l'arricchimento automatico dei dati (data enrichment) attingendo a un database di oltre 200 milioni di profili aziendali e di acquirenti su oltre quaranta attributi: firmografici, demografici e tecnografici. Non deduplica i record, non ricostruisce lo storico delle interazioni e non decide quale sistema abbia ragione quando due si contraddicono.
Sui buchi anagrafici è un investimento che si ripaga, perché riempire a mano settore, dimensione aziendale e tecnologie in uso costa molto più di quanto costi l'arricchimento.
Vale però la pena sapere che si tratta di un dataset B2B, che non restituisce indirizzi email personali né numeri di telefono, quindi non è una soluzione per i casi in cui il problema è la raggiungibilità del prospect.
Il punto importante è un altro: l'arricchimento aggiunge attributi esterni a un record, mentre i tre guasti descritti sopra riguardano la struttura del record stesso. Se l'identità è frammentata, arricchire significa comprare dati corretti e scriverli sul duplicato sbagliato.
Qual è la checklist da verificare prima di attivare il lead scoring predittivo?
I controlli sono sette: copertura dei campi che il modello userà, proprietà a valori controllati invece che a testo libero, storico attendibile, deduplica fatta con regole attive, lifecycle e pipeline allineati al processo reale, tracciabilità delle azioni degli agenti AI e base giuridica verificata per la profilazione.
I sette controlli, uno per uno
- Copertura dei campi. Conta quanti record hanno effettivamente un valore nei campi che il modello userà, perché sotto una certa soglia di compilazione non si ottiene un modello predittivo ma un generatore di ipotesi.
- Proprietà a valori controllati. Convertire i campi a testo libero in liste chiuse è la parte più noiosa del progetto ed è anche quella con il rendimento più alto, perché rende confrontabili dati che prima non lo erano.
- Storico attendibile. I modelli imparano dal passato, quindi se il passato è stato riscritto da una migrazione fatta di fretta ogni previsione eredita quell'errore. Otto mesi di dati veri valgono più di tre anni di dati ricostruiti.
- Deduplica fatta e regole attive. Non basta l'intervento una tantum, serve la regola che impedisce ai duplicati di riformarsi.
- Lifecycle e pipeline allineati. Senza una definizione condivisa di MQL il punteggio non trova un riferimento stabile a cui agganciarsi.
- Tracciabilità. Quando un agente AI modifica un record occorre poter ricostruire che cosa ha cambiato e perché. HubSpot registra a timeline le azioni degli agenti con le proprietà modificate e il contesto della decisione, ma conviene verificare che cosa sia effettivamente disponibile nel proprio portale, perché Agent Hub e Agent Builder stanno completando il rollout su Professional ed Enterprise.
- Base giuridica. Profilazione, scoring predittivo e dati provenienti da fornitori terzi vanno verificati prima dell'attivazione, perché mezza giornata di lavoro adesso costa molto meno della stessa verifica fatta dopo un reclamo.
Quanto tempo serve per preparare un CRM al predittivo?
Per un'istanza di medie dimensioni la bonifica si misura in settimane e non in giorni, indicativamente da quattro a dodici a seconda di quanti sistemi sono collegati e di quanto è stratificato lo storico. La risorsa scarsa però non è tecnica: è il tempo delle persone che conoscono i processi e devono prendere le decisioni.
È anche la ragione per cui conviene non far coincidere questo lavoro con i trimestri di picco, quando le stesse persone stanno chiudendo il budget o tenendo in piedi la stagione commerciale. Rimandare però ha un costo che si vede poco e pesa parecchio, perché ogni settimana passata a raccogliere dati sporchi è una settimana di training set compromessa, e i trimestri in cui se ne raccolgono di più sono proprio quelli di picco.
Da dove partire
Se stai valutando di attivare il lead scoring predittivo o un agente AI sul tuo CRM, la domanda da cui partire non è quale strumento comprare, ma se l'azienda sa rispondere con una sola versione dei fatti a quattro domande: chi è questo cliente, che cosa ha comprato, che cosa gli abbiamo detto e che cosa ci ha risposto.
Il tuo CRM è pronto per l'AI, o l'AI amplificherà i problemi che ha già?
Noi di Webeing siamo Partner HubSpot certificati e possiamo fare insieme un assessment del tuo portale. E ricorda…
L'AI non risolve il debito di dati. Lo rende visibile, e lo moltiplica alla velocità delle macchine.